2. Rekursion
Rekursion
Abschnitt betitelt „Rekursion“Rekursion bezeichnet das Prinzip, dass etwas in seiner eigenen Definition vorkommt. In der Programmierung heißt das konkret: Eine Funktion ruft sich selbst auf. Was zunächst nach einer Endlosschleife klingt, ist bei korrekter Konstruktion eine der wichtigsten Techniken der Informatik. Manche Probleme, die mit Schleifen nur mühsam lösbar sind, lassen sich rekursiv in wenigen Zeilen formulieren.
Rekursive Strukturen sind dabei keine Erfindung der Informatik, sondern überall vorhanden: Ein Ordner im Dateisystem enthält Dateien und weitere Ordner, die wieder Dateien und Ordner enthalten. Ein HTML-Dokument besteht aus Elementen, die Elemente enthalten. In einem Videoschnittprogramm können Sequenzen andere Sequenzen enthalten, in Photoshop Ebenengruppen weitere Ebenengruppen. Programme, die solche Daten verarbeiten, sind im Kern fast immer rekursiv.
Die Grundidee: verkleinern bis zum trivialen Fall
Abschnitt betitelt „Die Grundidee: verkleinern bis zum trivialen Fall“Der rekursive Ansatz lautet: Ein Problem wird gelöst, indem eine kleinere Version desselben Problems gelöst wird. Die kleinere Version wird nach demselben Schema auf eine noch kleinere zurückgeführt, bis ein Fall erreicht ist, dessen Lösung unmittelbar feststeht.
Jede korrekte rekursive Funktion besteht deshalb aus zwei Teilen:
- Basisfall: der triviale Fall, der ohne weiteren Selbstaufruf beantwortet wird. Er beendet die Rekursion.
- Rekursionsschritt: die Funktion ruft sich selbst auf, aber mit einem kleineren Problem, das dem Basisfall näher ist.
Fehlt der Basisfall oder wird das Problem nicht kleiner, terminiert die Rekursion nicht. Daraus ergibt sich die Kontrollfrage, die an jede rekursive Funktion zu stellen ist: Wo hört es auf, und kommt jeder Aufruf diesem Ende näher?
Das kleinste Beispiel: der Countdown
Abschnitt betitelt „Das kleinste Beispiel: der Countdown“def countdown(n): if n == 0: # base case print("Liftoff!") return print(n) countdown(n - 1) # recursive step: smaller problem
countdown(3)Ausgabe:
321Liftoff!Der Ablauf im Detail: countdown(3) gibt die 3 aus und ruft countdown(2) auf. Dieser gibt die 2 aus und ruft countdown(1) auf, der die 1 ausgibt und countdown(0) aufruft. Dort greift der Basisfall, Liftoff! wird ausgegeben, die Funktion kehrt zurück. Anschließend kehren auch die drei wartenden Aufrufe der Reihe nach zurück.
Der Call Stack
Abschnitt betitelt „Der Call Stack“Zur Laufzeit verwaltet Python die aktiven Funktionsaufrufe auf dem Call Stack: einem Stapel, auf dem für jeden Aufruf ein Eintrag (Stack Frame) mit den lokalen Variablen dieses Aufrufs liegt. Bei Rekursion liegen also mehrere Frames derselben Funktion übereinander:
flowchart TB
    subgraph stack["Call Stack beim Erreichen des Basisfalls"]
        direction TB
        d0["countdown(0) - läuft gerade"]
        d1["countdown(1) - wartet"]
        d2["countdown(2) - wartet"]
        d3["countdown(3) - wartet"]
        d0 --- d1 --- d2 --- d3
    end
Zwei Punkte sind hier zentral:
countdown(3)ist nicht beendet, währendcountdown(2)läuft. Der Aufruf steht in der Zeile des Selbstaufrufs und wartet auf dessen Rückkehr.- Jeder Frame hat sein eigenes
n. Es gibt nicht eine Variablen, die sich ändert, sondern vier unabhängige Variablennmit den Werten 3, 2, 1 und 0.
Der Call Stack lässt sich direkt beobachten: Setzen Sie in VS Code einen Breakpoint in die Funktion und starten Sie den Debugger. Das Panel Call Stack zeigt bei jedem Selbstaufruf einen Eintrag mehr, und jeder Frame kann einzeln mit seinen Variablenwerten inspiziert werden. Diese Übung ist dringend zu empfehlen; sie macht den Mechanismus sichtbar, der Rekursion trägt.
Anweisung vor oder nach dem Selbstaufruf
Abschnitt betitelt „Anweisung vor oder nach dem Selbstaufruf“Die Position einer Anweisung relativ zum Selbstaufruf bestimmt, wann sie ausgeführt wird:
def count_up(n):    if n == 0:        print("Liftoff!")        return    count_up(n - 1)    print(n)                # runs AFTER the recursive call returns

count_up(3)Liftoff!123Dieselbe Funktion mit einer verschobenen Zeile zählt aufwärts statt abwärts. Der Grund: Die print-Anweisungen werden jetzt beim Abbau des Stapels ausgeführt, also in umgekehrter Reihenfolge der Aufrufe. Arbeit auf dem Rückweg zu erledigen ist ein wiederkehrendes Muster rekursiver Funktionen.
Klassiker 1: die Fakultät
Abschnitt betitelt „Klassiker 1: die Fakultät“Die Fakultät n! ist das Produkt der Zahlen 1 bis n, also 5! = 5 · 4 · 3 · 2 · 1 = 120. Die Mathematik definiert sie rekursiv:
- 0! = 1 (Basisfall)
- n! = n · (n-1)! (Rekursionsschritt)
Diese Definition lässt sich beinahe wörtlich in Python übertragen:
def factorial(n): if n == 0: return 1 return n * factorial(n - 1)Die Auswertung von factorial(4), schriftlich expandiert:
factorial(4)= 4 * factorial(3)= 4 * (3 * factorial(2))= 4 * (3 * (2 * factorial(1)))= 4 * (3 * (2 * (1 * factorial(0))))= 4 * (3 * (2 * (1 * 1)))= 4 * (3 * (2 * 1))= 4 * (3 * 2)= 4 * 6= 24Diese händische Expansion ist die wichtigste Übungstechnik des Kapitels. Wer eine rekursive Funktion nicht durchschaut, schreibt sie für einen kleinen Eingabewert in dieser Form aus.
Klassiker 2: Fibonacci und die Kosten naiver Rekursion
Abschnitt betitelt „Klassiker 2: Fibonacci und die Kosten naiver Rekursion“Die Fibonacci-Folge 0, 1, 1, 2, 3, 5, 8, 13, 21, … definiert jede Zahl als Summe ihrer beiden Vorgänger. Die rekursive Umsetzung benötigt zwei Basisfälle und zwei Selbstaufrufe:
def fib(n): if n == 0: return 0 if n == 1: return 1 return fib(n - 1) + fib(n - 2)Die Funktion ist korrekt, aber ab etwa n = 35 unbrauchbar langsam. Der Aufrufbaum für fib(5) zeigt die Ursache:
flowchart TB
    a["fib(5)"] --> b["fib(4)"]
    a --> c["fib(3)"]
    b --> d["fib(3)"]
    b --> e["fib(2)"]
    d --> f["fib(2)"]
    d --> g["fib(1)"]
    c --> h["fib(2)"]
    c --> i["fib(1)"]
    e --> j["fib(1)"]
    e --> k["fib(0)"]
    f --> l["fib(1)"]
    f --> m["fib(0)"]
    h --> n["fib(1)"]
    h --> o["fib(0)"]
fib(3) wird zweimal vollständig berechnet, fib(2) dreimal. Die Zahl der Aufrufe wächst exponentiell: fib(40) benötigt über eine Milliarde Aufrufe für ein Ergebnis, das eine Schleife in 40 Durchläufen liefert.
Die Schlussfolgerung lautet nicht “Rekursion ist langsam”, sondern präziser: Rekursion, die dieselben Teilprobleme mehrfach löst, ist langsam. Dagegen gibt es zwei Standardauswege:
# option 1: iterative version with two tracking variablesdef fib_iterative(n):    a, b = 0, 1    for _ in range(n):        a, b = b, a + b    return a

# option 2: recursion with memoizationdef fib_memo(n, known={}):    if n in known:        return known[n]    if n <= 1:        return n    known[n] = fib_memo(n - 1) + fib_memo(n - 2)    return known[n]
Die Memoisierung speichert jedes berechnete Ergebnis in einem Dictionary; jedes Teilproblem wird damit nur einmal gelöst. Für fib(40) sinkt die Zahl der Berechnungen von über einer Milliarde auf 79. Der Unterschied lässt sich messen:
import time
start = time.perf_counter()fib(32)print(f"naive: {time.perf_counter() - start:.3f} s")
start = time.perf_counter()fib_memo(32)print(f"memo:  {time.perf_counter() - start:.6f} s")
Rekursion an Datenstrukturen
Abschnitt betitelt „Rekursion an Datenstrukturen“Bei Zahlenproblemen ist Rekursion eine Alternative zur Schleife. Ihre eigentliche Stärke zeigt sie bei Daten, die selbst rekursiv aufgebaut sind, also Strukturen enthalten, die den Gesamtstrukturen gleichen.
Verschachtelte Listen
Abschnitt betitelt „Verschachtelte Listen“Eine Playlist kann einzelne Titel enthalten, aber auch Unter-Playlists. Als verschachtelte Liste von Spieldauern in Sekunden:
playlist = [240, [180, 320, [90, 150]], 200, [60, 60]]Eine einfache Schleife scheitert an den inneren Listen. Die rekursive Lösung unterscheidet genau zwei Fälle: Das Element ist eine Zahl (direkt verarbeiten) oder eine Liste (Selbstaufruf):
def total_duration(entries):    total = 0    for entry in entries:        if isinstance(entry, list):            total += total_duration(entry)   # sublist: same problem, smaller        else:            total += entry                   # number: add directly    return total

print(total_duration(playlist))    # 1300
isinstance(x, list) prüft, ob ein Wert eine Liste ist. Bemerkenswert ist, dass die Verschachtelungstiefe im Code nirgends vorkommt: Die Funktion verarbeitet jede Tiefe, weil die Struktur des Codes der Struktur der Daten folgt.
Verzeichnisbäume
Abschnitt betitelt „Verzeichnisbäume“Das Dateisystem ist die bekannteste rekursive Struktur. Wer alle Bilddateien unterhalb eines Projektordners sucht, muss in jeden Unterordner absteigen, dort in jeden Unterordner, und so weiter:
from pathlib import Path
def find_images(folder):    hits = []    for entry in Path(folder).iterdir():        if entry.is_dir():            hits += find_images(entry)       # subfolder: descend        elif entry.suffix.lower() in (".png", ".jpg", ".jpeg"):            hits.append(entry)    return hits

for image in find_images("."): print(image)Der Basisfall ist hier implizit: Ein Ordner ohne Unterordner löst keine weiteren Selbstaufrufe aus. Nach diesem Schema arbeiten Dateisuche, Virenscanner und Backup-Programme.
Strings
Abschnitt betitelt „Strings“Auch Zeichenketten lassen sich rekursiv verkleinern, mit Slicing als Werkzeug. Beispiel Palindromtest (ein Wort liest sich vorwärts wie rückwärts gleich):
def is_palindrome(word):    if len(word) <= 1:                      # base case: empty or single char        return True    if word[0] != word[-1]:                 # outer characters differ        return False    return is_palindrome(word[1:-1])        # check the inner part

print(is_palindrome("rotator"))     # Trueprint(is_palindrome("python"))      # False
Die äußeren Zeichen werden verglichen, der innere Rest wird als kleineres Palindromproblem weitergereicht. Für diese konkrete Aufgabe existieren in Python auch kürzere iterative Lösungen; als Übung im rekursiven Denken ist die Variante trotzdem lehrreich.
Rekursion oder Schleife?
Abschnitt betitelt „Rekursion oder Schleife?“Grundsätzlich gilt: Jedes rekursiv formulierte Programm lässt sich auch iterativ formulieren und umgekehrt. Die Entscheidung ist daher eine Frage der Angemessenheit:
| Kriterium | Rekursion | Schleife |
|---|---|---|
| Lineare Abläufe (zählen, summieren) | möglich, aber umständlich | natürlich |
| Baumartige, verschachtelte Daten | natürlich | umständlich (eigener Stapel nötig) |
| Speicherbedarf | ein Stack Frame pro Aufruf | konstant |
| Geschwindigkeit | Funktionsaufrufe kosten Zeit | meist schneller |
| Nähe zur mathematischen Definition | hoch | gering |
Als Faustregel: Folgt die Struktur des Problems einem Baum oder einer Verschachtelung, ist Rekursion das passende Werkzeug. Ist das Problem eine einfache Wiederholung, ist die Schleife vorzuziehen. Fakultät und Fibonacci sind in diesem Sinn Lernbeispiele: gut zum Verstehen des Mechanismus, in Produktionscode würde man beide iterativ schreiben.
Grenzen: die maximale Rekursionstiefe
Abschnitt betitelt „Grenzen: die maximale Rekursionstiefe“Jeder wartende Aufruf belegt Speicher auf dem Call Stack. Python begrenzt die Tiefe auf etwa 1000 Ebenen und bricht darüber hinaus ab:
>>> def endless(n):... return endless(n + 1)...>>> endless(1)RecursionError: maximum recursion depth exceededEin RecursionError hat zwei mögliche Ursachen, die auseinanderzuhalten sind:
- Ein Programmierfehler. Der Basisfall fehlt, ist unerreichbar (etwa
n == 0bei Aufruf mit negativer Zahl) oder das Problem wird nicht kleiner. Das ist der häufige Fall; die Rekursion wäre nie fertig geworden, der Fehler deckt das auf. - Die Struktur ist tatsächlich so tief. Eine korrekte Rekursion über eine Struktur mit 5000 Ebenen überschreitet das Limit ebenfalls. Dann ist eine iterative Umformulierung angebracht. Das Limit lässt sich zwar mit
sys.setrecursionlimit()erhöhen, das behandelt aber nur das Symptom und riskiert einen Absturz des Interpreters.
Zur Einordnung: Verzeichnisbäume sind selten tiefer als 20 Ebenen, JSON-Dokumente selten tiefer als 10. Für strukturell rekursive Aufgaben ist das Limit in der Praxis kaum je ein Hindernis.
Die Türme von Hanoi
Abschnitt betitelt „Die Türme von Hanoi“Das bekannteste Demonstrationsbeispiel für die Stärke der Rekursion. Die Aufgabe: Ein Turm aus n verschieden großen Scheiben soll von Stab A nach Stab C versetzt werden. Regeln:
- Pro Zug wird genau eine Scheibe bewegt, und zwar die oberste eines Stapels.
- Eine größere Scheibe darf nie auf einer kleineren liegen.
- Ein dritter Stab B dient als Zwischenlager.
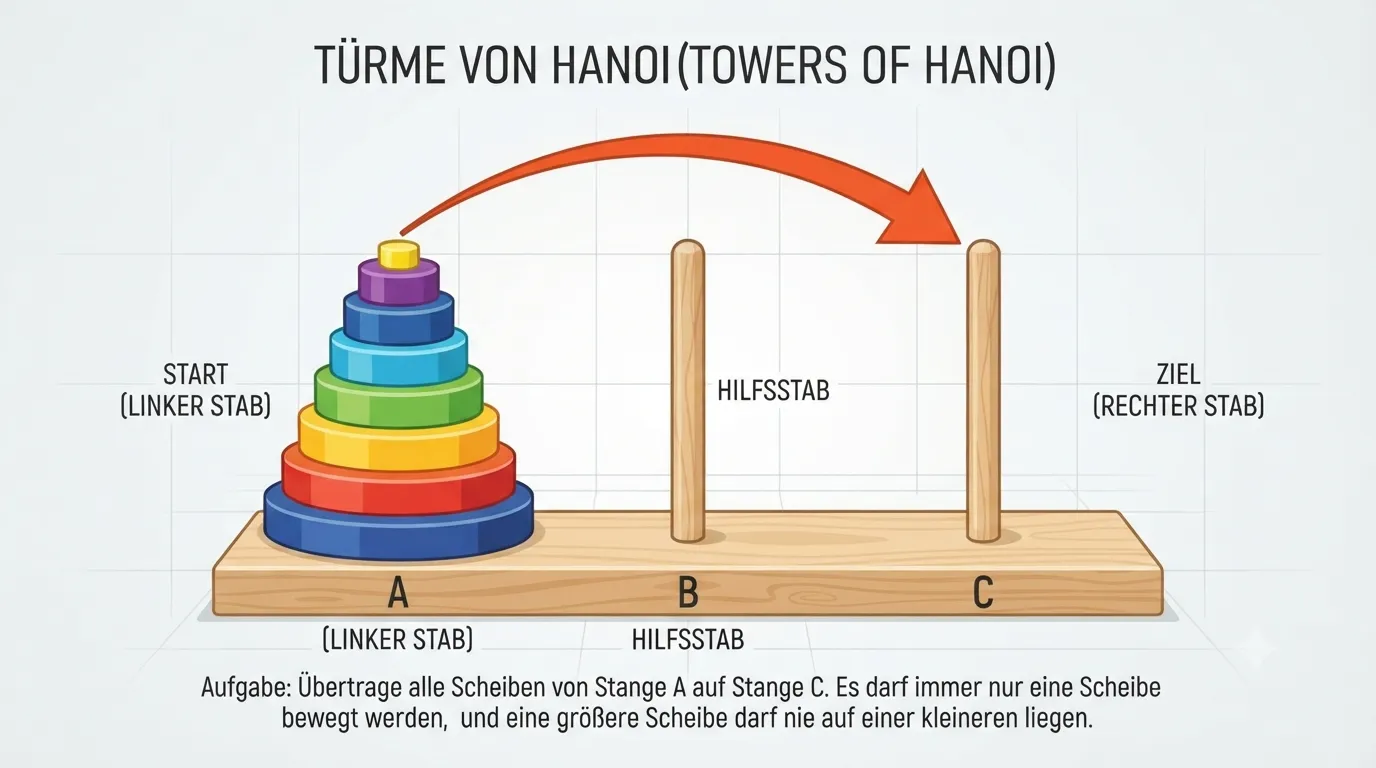
Der Versuch, das Problem ab vier Scheiben durch Probieren zu lösen, endet regelmäßig im Chaos. Die rekursive Zerlegung dagegen ist kurz:
Um n Scheiben von A nach C zu bringen: Bringe die oberen n-1 Scheiben von A nach B, bewege die größte Scheibe von A nach C, bringe die n-1 Scheiben von B nach C.
Wie die n-1 Scheiben bewegt werden, beantwortet dieselbe Vorschrift eine Ebene tiefer. Der Basisfall: Null Scheiben erfordern keinen Zug.
def hanoi(n, source, target, spare):    if n == 0:        return    hanoi(n - 1, source, spare, target)    print(f"disk {n}: {source} -> {target}")    hanoi(n - 1, spare, target, source)

hanoi(3, "A", "C", "B")
disk 1: A -> Cdisk 2: A -> Bdisk 1: C -> Bdisk 3: A -> Cdisk 1: B -> Adisk 2: B -> Cdisk 1: A -> CFünf Zeilen Logik für ein Problem, dessen iterative Lösung erheblich komplizierter ist. Die minimale Zugzahl beträgt 2ⁿ - 1; sie wächst also exponentiell mit der Scheibenzahl. Für 64 Scheiben sind das rund 18,4 Trillionen Züge. Bei einem Zug pro Sekunde entspricht das mehr als 580 Milliarden Jahren; manche Probleme sind trotz korrektem Algorithmus praktisch unlösbar. Auch das ist eine Lektion dieses Beispiels.
Checkliste für eigene rekursive Funktionen
Abschnitt betitelt „Checkliste für eigene rekursive Funktionen“-
Basisfall zuerst. Den kleinsten Fall formulieren, dessen Antwort unmittelbar feststeht, und ihn als erstes
ifin die Funktion schreiben. -
Der Schritt verkleinert das Problem. Jeder Selbstaufruf erfolgt mit einem Argument, das dem Basisfall näher ist:
n - 1,word[1:-1], der Unterordner. -
Induktiv prüfen. Den Rekursionsschritt unter der Annahme kontrollieren, dass der Selbstaufruf korrekt liefert, statt den gesamten Aufrufbaum durchzudenken.
-
Von Hand expandieren. Bei Unklarheit den Aufruf für einen kleinen Wert schriftlich ausrollen, wie oben bei
factorial(4). -
Grenzfälle testen. 0, 1, leere Liste, leerer String, Ordner ohne Inhalt. Fehlerhafte Basisfälle zeigen sich genau dort.
Lernergebnisse: Was Sie nach diesem Kapitel können sollten
Abschnitt betitelt „Lernergebnisse: Was Sie nach diesem Kapitel können sollten“Nach Abschluss dieses Kapitels sollten Schülerinnen und Schüler in der Lage sein:
- Erklären: das Konzept der Rekursion sowie die Begriffe Basisfall, Rekursionsschritt und Call Stack erklären.
- Analysieren: den Ablauf einer rekursiven Funktion von Hand verfolgen und ihre Aufrufstruktur skizzieren.
- Anwenden: rekursive Funktionen für Zahlenprobleme (Fakultät, Summen) und für verschachtelte Strukturen (Listen, Verzeichnisse) schreiben.
- Beurteilen: für ein gegebenes Problem begründet zwischen rekursiver und iterativer Lösung wählen.
- Nennen: Anwendungsgebiete und Grenzen der Rekursion (baumartige Daten, mehrfach gelöste Teilprobleme, Rekursionstiefe) nennen.
Passende Übungen
Abschnitt betitelt „Passende Übungen“- Aufgabe 03 - Rekursion I
- Aufgabe 04 - Rekursion II
- Aufgabe 05 - Rekursion III