3.1 Asynchrones JavaScript: Event Loop und Promises
Nach dieser Einheit kannst du:
- das Ausführungsmodell von JavaScript (Call Stack, Event Loop, Microtask- und Task-Queue) erklären und die Ausgabereihenfolge von Code mit Timern und Promises vorhersagen.
- die drei Zustände eines Promise beschreiben und die Fehler einer Promise-Kette mit einem einzigen
catchbehandeln. - denselben Ablauf als verschachtelte Callbacks und als Promise-Kette lesen und vergleichen.
Ein Kellner nimmt an Tisch 1 eine Bestellung auf, gibt den Zettel in die Küche - und bleibt dann nicht zehn Minuten vor der Durchreiche stehen, bis das Schnitzel fertig ist. Er nimmt in der Zwischenzeit Tisch 2 und 3 auf, kassiert bei Tisch 4 und holt das Schnitzel, sobald die Glocke läutet. Ein einziger Kellner bedient so ein ganzes Lokal. Genau so arbeitet JavaScript.
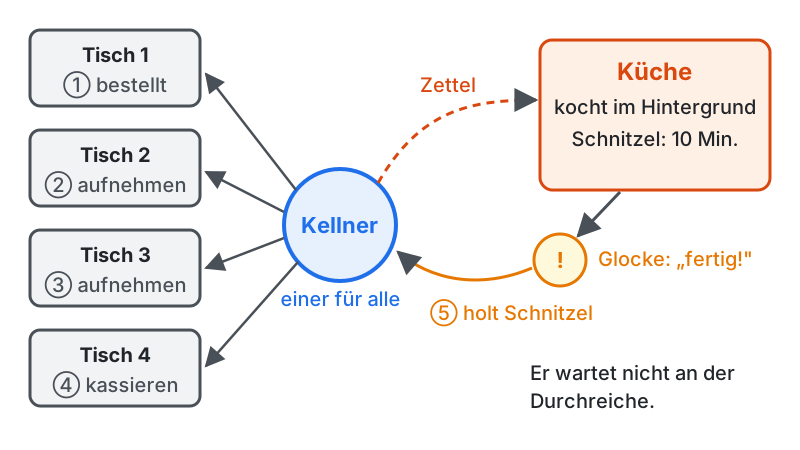
Programme warten ständig: auf eine Datei, auf eine Netzwerkantwort, auf einen Timer, auf den nächsten Klick. Die Frage ist, was während des Wartens passiert. Ein Programm, das bei jeder Wartezeit stillsteht, ist auf dem Server ein Durchsatzproblem und im Browser eine Katastrophe: Die Oberfläche friert ein, kein Klick, kein Scrollen, nichts.
Nebenläufigkeit heißt, Wartezeiten zu überbrücken, indem in der Zwischenzeit anderes erledigt wird. Der Lehrplan verlangt ausdrücklich, Anwendungssysteme unter Verwendung von Nebenläufigkeit zu entwickeln. JavaScript löst das mit einem eigenwilligen, aber sehr erfolgreichen Modell: eine Ausführungsspur plus Warteschlangen für alles, was später passieren soll.
Das Kellner-Bild hat eine Grenze, die du dir gleich merken solltest: Ein echter Kellner kann ein Gespräch abbrechen, wenn die Glocke läutet. JavaScript kann das nicht. Ein laufender Schritt wird immer erst fertig ausgeführt, bevor der nächste drankommt.
Kapitel 3 baut das Modell in drei Einheiten von unten auf. Diese Einheit beginnt mit dem Event Loop, dann folgen Promises als Ordnung für “später” und die zweite Warteschlange. Einheit 3.2 bringt async/await als lesbare Schreibweise samt den typischen Fallen, Einheit 3.3 die Entscheidung zwischen nacheinander und gleichzeitig. Die drei Wochen dafür sind gut investiert: Asynchroner Code ist die Grundlage von allem, was in diesem Jahr folgt, vom API-Aufruf bis zur Server-Komponente.
Begriffe vorab
Abschnitt betitelt „Begriffe vorab“- Thread (Ausführungsstrang): eine eigene Ausführungsspur mit eigenem Call Stack. Ein Programm kann mehrere Threads haben, die gleichzeitig arbeiten.
- Call Stack (Aufrufstapel): die Liste der Funktionen, die gerade ausgeführt werden. JavaScript hat genau einen, im Lokal ist das der Kellner.
- blockieren: Ein Programm steht still, bis eine langsame Operation fertig ist, und kann in der Zeit nichts anderes tun.
- Callback (Rückruffunktion): eine Funktion, die du übergibst, damit sie später aufgerufen wird, etwa wenn ein Timer abläuft.
- Task-Queue und Microtask-Queue: zwei Warteschlangen für Callbacks, die ausgeführt werden sollen, sobald der Call Stack leer ist; die Microtask-Queue hat Vorrang.
- Event Loop (Ereignisschleife): der Mechanismus, der Callbacks aus den Warteschlangen holt und ausführt, sobald der Call Stack leer ist.
- Promise: ein Objekt, das ein Ergebnis vertritt, das erst später feststeht.
Der Event Loop: eine Spur, viele Aufgaben
Abschnitt betitelt „Der Event Loop: eine Spur, viele Aufgaben“JavaScript führt Code single-threaded aus: genau eine Anweisung zur Zeit, auf genau einem Call Stack. Langsame Operationen (Timer, Netzwerk, Dateizugriff) reicht die Laufzeitumgebung an das System weiter und nimmt stattdessen einen Callback entgegen. Fertige Callbacks landen in einer Warteschlange, und der Event Loop arbeitet sie ab, sobald der Call Stack leer ist.
flowchart LR
    accTitle: Der Event Loop holt Callbacks aus der Task-Queue
    code["Call Stack (dein Code)"] -- "setTimeout, fetch, ..." --> apis["Web-APIs / Laufzeit"]
    apis -- "fertig: Callback einreihen" --> queue["Task-Queue"]
    queue -- "Event Loop: wenn der Stack leer ist" --> code
Abb. 3.2: Langsame Arbeit geht an die Laufzeit, fertige Callbacks warten in der Task-Queue (eigene Darstellung).
Das klassische Experiment dazu:
console.log("one");setTimeout(() => console.log("two"), 0);console.log("three");// output: one, three, twoBeispielprojekt: 03_async_javascript_examples/ex01_event_loop_timeout
Obwohl der Timer auf 0 Millisekunden steht, kommt two zuletzt: setTimeout legt den Callback nur in die Warteschlange. Die kommt erst dran, wenn der laufende Code vollständig fertig ist.
Genauer erklärt: Daraus folgt direkt, dass Blockieren alles blockiert. Eine Endlosschleife oder eine schwere Berechnung hält nicht nur sich selbst auf, sondern auch jeden wartenden Callback. Konkret heißt das: Rechnet eine Schleife zwei Sekunden lang, läuft ein Timer mit 0 Millisekunden frühestens nach diesen zwei Sekunden, und im Browser reagiert die Seite so lange auf keinen Klick.
Im Bild vom Anfang: Der Kellner ist der Call Stack, die Küche ist die Laufzeitumgebung, die Glocke an der Durchreiche die Warteschlange. Und ein Kellner, der sich mit einem Gast in ein zwanzigminütiges Gespräch verwickelt, lässt das ganze Lokal warten.
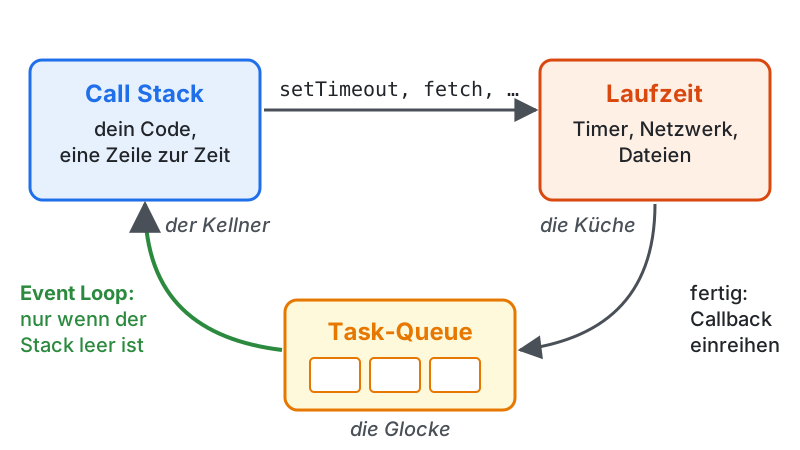
Wo begegnet dir das? Wenn eine Webseite nicht mehr auf Klicks reagiert und der Browser anbietet, sie zu beenden, blockiert meist ein Skript den einzigen Call Stack der Seite. Auf der anderen Seite steht Node.js: Ein einziger Node-Prozess bedient viele gleichzeitige Anfragen, weil er während jeder Datenbank- oder Netzwerkantwort schon die nächste Anfrage annimmt, genau wie der Kellner.
Ein Thread für deinen Code, viele Threads im Browser
Abschnitt betitelt „Ein Thread für deinen Code, viele Threads im Browser““JavaScript ist single-threaded” klingt, als hätte der ganze Browser nur einen einzigen Thread. Das stimmt nicht. Ein moderner Browser wie Chrome verteilt seine Arbeit auf mehrere Prozesse, und jeder davon hat mehrere Threads:
- Der Browser-Prozess zeichnet Adressleiste, Tabs und Knöpfe (UI-Thread), holt Daten aus dem Netz (Netzwerk-Thread) und greift auf Dateien zu (Storage-Thread).
- Ein eigener GPU-Prozess bringt die fertigen Bilder auf den Bildschirm.
- Jeder Tab, genauer jede Website, bekommt einen eigenen Renderer-Prozess. Darin läuft genau ein Hauptthread (Main Thread) mit Call Stack, Event Loop und Warteschlangen. Er führt dein JavaScript aus und berechnet auch Styles und Layout der Seite. Daneben gibt es Hilfsthreads, die zum Beispiel das Scrollen flüssig halten (Compositor- und Raster-Threads), und auf Wunsch Worker-Threads.
flowchart TB
    accTitle: Der Browser hat viele Threads, dein Code läuft auf einem
    subgraph browser["Browser-Prozess"]
        ui["UI-Thread"]
        net["Netzwerk-Thread"]
        storage["Storage-Thread"]
    end
    gpu["GPU-Prozess"]
    subgraph tab1["Renderer-Prozess Tab 1"]
        main1["Hauptthread: dein JavaScript, Event Loop, Layout"]
        helper1["Compositor- und Raster-Threads"]
        worker1["Worker-Threads (optional)"]
    end
    subgraph tab2["Renderer-Prozess Tab 2"]
        main2["Hauptthread: dein JavaScript, Event Loop, Layout"]
        helper2["Compositor- und Raster-Threads"]
    end
    browser --- tab1
    browser --- tab2
    browser --- gpu
Abb. 3.3a: Der Browser arbeitet mit vielen Threads, dein JavaScript-Code einer Seite läuft aber auf genau einem, dem Hauptthread (eigene Darstellung nach Chrome for Developers).
Warum sagt man dann trotzdem “JavaScript ist single-threaded”? Weil die Aussage deinen Code meint, nicht den Browser. Jede Zeile JavaScript einer Seite läuft auf dem einen Hauptthread, und keiner der anderen Threads führt auch nur eine davon aus. Sie erledigen die Arbeit der Laufzeit: Während ein fetch läuft, wartet der Netzwerk-Thread auf die Antwort, und dein Hauptthread arbeitet längst weiter. Im Lokal heißt das: In der Küche stehen mehrere Köche gleichzeitig am Herd, aber es gibt nur einen Kellner, und nur er nimmt Bestellungen auf. Node.js ist genauso gebaut: Dein Code läuft auf einem Thread, Dateizugriffe erledigt im Hintergrund ein Pool von Hilfsthreads.
Daraus erklärt sich auch die eingefrorene Seite von oben. Blockiert ein Skript den Hauptthread, friert nur diese Seite ein. Andere Tabs haben ihren eigenen Hauptthread und reagieren weiter, und weil die Adressleiste im Browser-Prozess läuft, kann der Browser dir anbieten, die hängende Seite zu beenden.
Eigene zusätzliche Threads für deinen Code gibt es übrigens auch: Worker. Ein Worker hat aber seinen eigenen Call Stack und Event Loop und teilt keine Variablen mit dem Hauptthread. Wie das funktioniert und wofür du ihn brauchst, zeigt Einheit 4.2.
Auflösung
Zuerst loop done nach rund zwei Sekunden, unmittelbar danach timer. Der Timer ist zwar nach 0 Millisekunden abgelaufen, sein Callback wartet aber in der Task-Queue, bis der Call Stack leer ist, und das ist er erst nach der Schleife. In Node.js 24 gemessen: loop done nach 2000 ms, timer nach 2010 ms.
Callbacks und ihr Problem
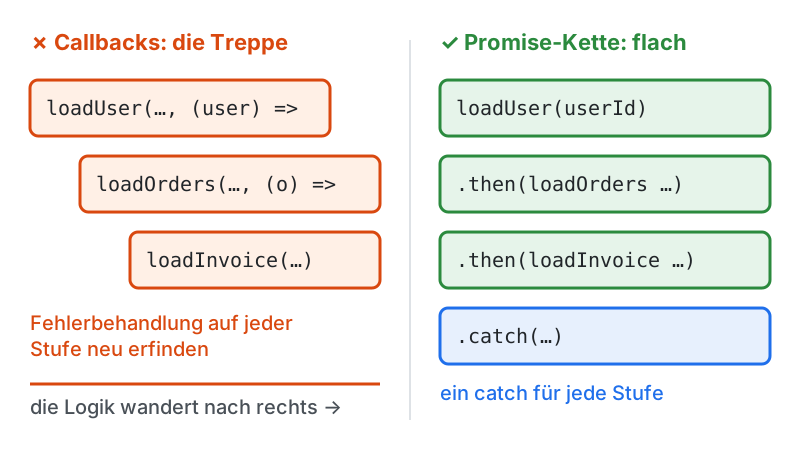
Abschnitt betitelt „Callbacks und ihr Problem“Callbacks funktionieren, skalieren aber schlecht. Sobald Schritte aufeinander aufbauen (lade A, dann damit B, dann damit C), verschachteln sich die Funktionen zur berüchtigten Treppe, der Callback Hell (auch Pyramid of Doom):
loadUser(userId, (user) => { loadOrders(user, (orders) => { loadInvoice(orders[0], (invoice) => { console.log(invoice.total); // and error handling for each step? somewhere in here, three times }); });});Beispielprojekt: 03_async_javascript_examples/ex02_callback_hell
Diese Form ist schwer zu lesen, und die Fehlerbehandlung muss auf jeder Stufe einzeln erfunden werden. Moderne JavaScript-APIs verwenden Callbacks deshalb fast nur noch für Ereignisse (Klicks, Timer). Für “Ergebnis kommt später” gibt es eine bessere Abstraktion, die der nächste Abschnitt zeigt.
Wo begegnet dir das? Bei jedem addEventListener("click", ...) und jedem setTimeout übergibst du einen Callback, und dort ist er auch richtig. Node.js zeigt den Wandel direkt: Das Modul node:fs bietet jede Dateioperation mit Callback an, node:fs/promises dieselben Operationen als Promises.
Promises: ein Platzhalter für später
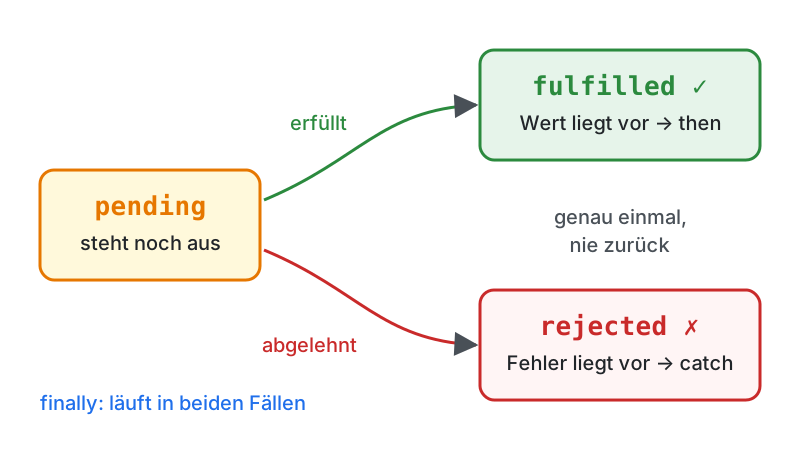
Abschnitt betitelt „Promises: ein Platzhalter für später“Ein Promise ist ein Objekt, das ein zukünftiges Ergebnis vertritt. Es befindet sich in genau einem von drei Zuständen:
| Zustand | Bedeutung |
|---|---|
pending | Ergebnis steht noch aus |
fulfilled | erfolgreich, Wert liegt vor |
rejected | fehlgeschlagen, Fehler liegt vor |
Der Übergang passiert genau einmal: von pending nach fulfilled oder rejected, nie zurück.
Mit dem Promise arbeitest du über seine Methoden:
loadUser(userId) .then((user) => loadOrders(user)) .then((orders) => loadInvoice(orders[0])) .then((invoice) => console.log(invoice.total)) .catch((error) => console.error("failed:", error.message)) .finally(() => console.log("done either way"));Beispielprojekt: 03_async_javascript_examples/ex03_promise_chain
then registriert die Weiterverarbeitung und liefert selbst wieder ein Promise. Dadurch entsteht statt der Treppe eine flache Kette. Gibt ein then-Callback ein Promise zurück, wartet die Kette darauf.
Genauer erklärt: Die Fehlerbehandlung, die bei Callbacks dreimal erfunden werden musste, steht damit genau einmal. Scheitert zum Beispiel schon loadUser, überspringt die Kette alle drei then-Stufen, springt direkt ins catch und führt danach finally aus.
Selbst erzeugen lässt sich ein Promise mit dem Konstruktor. Das brauchst du vor allem, um alte Callback-APIs zu verpacken oder Wartezeiten zu bauen:
function sleep(milliseconds) { return new Promise((resolve) => setTimeout(resolve, milliseconds));}Beispielprojekt: 03_async_javascript_examples/ex04_sleep
In TypeScript sind Promises generisch (Generics): Promise<Invoice> ist das Versprechen auf eine Rechnung, Promise<void> das Versprechen auf “fertig, aber ohne Wert”. Diese Typen dokumentieren asynchrone Funktionen präzise und tauchen ab jetzt in jeder Signatur auf.
Wo begegnet dir das? Wie holt eine Wetter-App die aktuellen Daten vom Server? Im Browser und in Node.js mit fetch(), und fetch() liefert ein Promise auf die Antwort (Promise<Response>). Ab Kapitel 5 steht das in fast jedem Programm.
Auflösung
Das Promise von loadUser ist rejected, also werden alle drei then-Callbacks übersprungen. Es laufen nur noch catch und finally. Die Ausgabe lautet failed: no user unknown und danach done either way. Ausprobieren kannst du das in ex03_promise_chain, indem du userId auf "unknown" setzt.
Zwei Warteschlangen: Microtasks vor Tasks
Abschnitt betitelt „Zwei Warteschlangen: Microtasks vor Tasks“Das Bild vom Anfang hatte eine Warteschlange, in Wahrheit sind es zwei, und sie haben unterschiedlichen Vorrang:
- Die Microtask-Queue nimmt die Callbacks von Promises auf (
then,catch,finallyund die Fortsetzung nach einemawait, das du in Einheit 3.2 kennenlernst). - Die Task-Queue (auch Macrotask-Queue) nimmt Timer-Callbacks (
setTimeout), Ereignisse und I/O-Ergebnisse auf.
Sobald der Call Stack leer ist, leert der Event Loop zuerst die Microtask-Queue vollständig, auch Microtasks, die währenddessen neu dazukommen. Erst dann holt er einen Task aus der Task-Queue. Danach wieder alle Microtasks, dann der nächste Task.
Im Lokal vom Anfang sieht das so aus:
- Task-Queue = neue Bestellungen der Tische
- Microtask-Queue = kleine Nacharbeiten zur Bestellung, die der Kellner gerade erledigt
Stell dir vor, der Kellner macht an der Theke einen Kaffee für Tisch 1:
- Tisch 1 bestellt einen Kaffee (Task).
- Beim Zubereiten merkt der Kellner: “Milch holen” (Microtask).
- Beim Milchholen merkt er: “Löffel mitnehmen” (weitere Microtask, sie kommt erst während der Nacharbeit dazu).
Es wäre unpraktisch, nach dem Milchholen zuerst die neue Bestellung von Tisch 2 aufzunehmen und den Löffel erst später zu bringen. Deshalb erledigt der Kellner zuerst alle Nacharbeiten, auch die neu dazugekommenen, und nimmt erst dann die nächste Bestellung an. Genau so leert der Event Loop die Microtask-Queue, bevor er den nächsten Task holt.
flowchart LR
    accTitle: Zuerst alle Microtasks, dann ein Task
    code["Call Stack"] -- "setTimeout, fetch, ..." --> apis["Laufzeit"]
    apis -- "Timer/I/O fertig" --> tasks["Task-Queue"]
    code -- "then, await" --> micro["Microtask-Queue"]
    micro -- "1. zuerst alle" --> code
    tasks -- "2. dann einer" --> code
Abb. 3.6: Woher die beiden Warteschlangen ihre Callbacks bekommen (eigene Darstellung).
console.log("A");setTimeout(() => console.log("B"), 0); // taskPromise.resolve().then(() => console.log("C")); // microtaskconsole.log("D");// output: A, D, C, BBeispielprojekt: 03_async_javascript_examples/ex05_microtask_vs_task
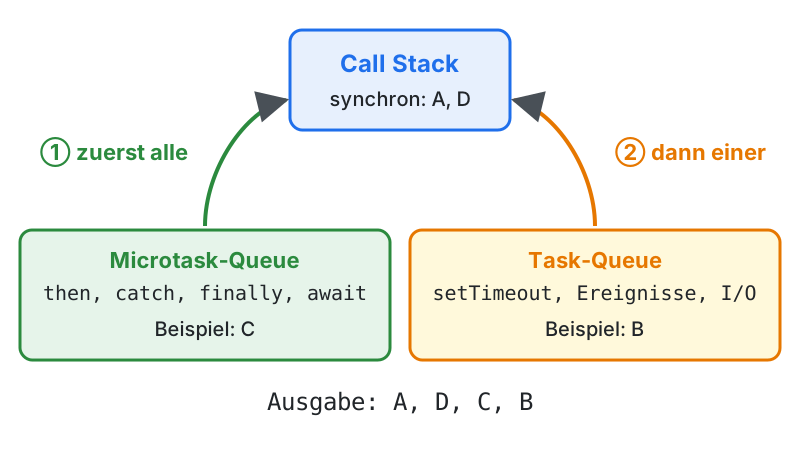
Genauer erklärt: C steht im Code vor D, kommt aber danach, weil jeder Promise-Callback erst nach dem synchronen Code läuft. Und B kommt nach C, obwohl sein Timer schon abgelaufen ist, weil die Microtask-Queue zuerst leer werden muss. Für die Praxis ist das selten entscheidend, für das Vorhersagen von Ausgaben (Aufgabe 03-1a) aber schon.
Wo begegnet dir das? Beim Debuggen mit console.log: Eine Ausgabe in einem then erscheint nach allen synchronen Ausgaben, auch wenn das Promise schon erfüllt ist. Wer das nicht weiß, sucht den Fehler an der falschen Stelle, weil die Reihenfolge im Terminal nicht der Reihenfolge im Code entspricht.
Stolperfallen
Abschnitt betitelt „Stolperfallen“- “Timer 0 heißt sofort”: Ein Timer-Callback kommt frühestens nach dem synchronen Code und nach allen Microtasks.
- Blockierender Code: Eine lange Schleife oder schwere Berechnung hält jeden wartenden Callback auf; im Browser reagiert die Seite so lange auf keinen Klick.
- Fehlerbehandlung in jeder Callback-Stufe neu erfinden: In einer Promise-Kette genügt ein
catcham Ende.
Zusatzmaterialien
Abschnitt betitelt „Zusatzmaterialien“- javascript.info: Event loop - Microtasks und Macrotasks mit vielen Reihenfolge-Beispielen; ideale Vorbereitung auf Aufgabe 03-1a.
- javascript.info: Promises, async/await - das komplette Kapitel von Callbacks bis
async/await, mit Aufgaben und Lösungen. - MDN: Using promises - die Referenz zu Verkettung und Fehlerbehandlung.
- MDN: JavaScript execution model - wie Call Stack, Warteschlangen und run-to-completion genau zusammenspielen.
- Chrome for Developers: Inside look at modern web browser - vierteilige Serie über Prozesse und Threads im Browser, vom Browser-Prozess bis zum Hauptthread einer Seite.
Zum Anhören
Abschnitt betitelt „Zum Anhören“Du kannst dir diese Einheit kostenlos mit der Vorlesefunktion deines Browsers oder Betriebssystems vorlesen lassen (etwa „Laut vorlesen” in Edge), ohne Konto und ohne Upload; die Reihenfolge-Beispiele liest du dabei am Bildschirm mit. Freiwillig kannst du mit Google NotebookLM (Google-Konto nötig) aus diesem öffentlichen Text eine gesprochene Zusammenfassung erzeugen, auch auf Deutsch.
Lernergebnisse
Abschnitt betitelt „Lernergebnisse“Du kannst jetzt:
- das Ausführungsmodell von JavaScript (Call Stack, Event Loop, Microtask- und Task-Queue) erklären und die Ausgabereihenfolge von Code mit Timern und Promises vorhersagen.
- die drei Zustände eines Promise beschreiben und die Fehler einer Promise-Kette mit einem einzigen
catchbehandeln. - denselben Ablauf als verschachtelte Callbacks und als Promise-Kette lesen und vergleichen.
Passende Übungen
Abschnitt betitelt „Passende Übungen“- Aufgabe 03-1a - Reihenfolge-Rätsel, Stufe Wesentlich_überwiegend (Rätsel ohne
async/await)
Quellen
Abschnitt betitelt „Quellen“- Lehrplanbezug (Nebenläufigkeit) → Lehrplan der Höheren Lehranstalt für Informationstechnologie, B.2 Medientechnik, 2.1 Softwareentwicklung, IV. Jahrgang (zitiert auf der Kursseite Lehrplan und Ablauf)
- Event Loop, Call Stack, Task-Queue, Ausgabereihenfolge mit
setTimeout→ javascript.info: Event loop: microtasks and macrotasks - Laufender Code wird nicht unterbrochen (run-to-completion) → MDN: JavaScript execution model
- Browser-Prozess, GPU-Prozess, ein Renderer-Prozess pro Website → Chrome for Developers: Inside look at modern web browser (part 1)
- UI-, Netzwerk- und Storage-Thread im Browser-Prozess → Chrome for Developers: Inside look at modern web browser (part 2)
- Hauptthread, Worker-, Compositor- und Raster-Threads im Renderer-Prozess; Styles und Layout auf dem Hauptthread → Chrome for Developers: Inside look at modern web browser (part 3)
- Node.js: JavaScript auf einem Event-Loop-Thread, Worker Pool für Dateizugriffe → Node.js-Dokumentation: Don’t Block the Event Loop (or the Worker Pool)
- Microtasks vor Tasks, Vorrang der Microtask-Queue → MDN: Using microtasks in JavaScript with queueMicrotask()
- Promise-Zustände
pending,fulfilled,rejected→ MDN: Promise - Verkettung mit
then,catch,finally→ MDN: Using promises fetch()liefert ein Promise auf einResponse-Objekt → MDN: Window: fetch() methodnode:fsmit Callback-, Promise- und synchroner Form jeder Dateioperation → Node.js-Dokumentation: File system- Messwert der Blockierschleife → eigene Messung mit Node.js 24.11.1 (Windows, Oktober 2026)
- Abb. 3.1 (Kellner und Küche), Abb. 3.2 (Event Loop, Mermaid), Abb. 3.3 (Event Loop mit den Begriffen aus dem Lokal), Abb. 3.3a (Prozesse und Threads im Browser, Mermaid, inhaltlich nach Chrome for Developers, siehe oben), Abb. 3.4 (Callbacks und Promise-Kette), Abb. 3.5 (Promise-Zustände), Abb. 3.6 (zwei Warteschlangen, Mermaid), Abb. 3.7 (Beispiel A, D, C, B) → eigene Darstellung
Autoren
Abschnitt betitelt „Autoren“- Oliver Maurhart (MAO)
- Michael Gabriel (GAM)
CC-BY-SA